Python爬虫如何爬取span和span中间的内容并分别存入字典里?
问题描述
我想把房屋概况分别抓出来并分别作为独立的列存储进字典里,但是行内元素没有办法直接用for循环抠出来。这是我的代码:
soup.select(’.house-info li’)[1].text.strip()
这是网页html代码:
<li><span class='info-tit'>房屋概况:</span>住宅<span class='splitline'>|</span>1室1厅1卫<span class='splitline'>|</span><span>46m²</span><span class='splitline'>|</span> (高层)/共18层<span class='splitline'>|</span>南北<span class='splitline'>|</span> 豪华装修 </li>
问题解答
回答1:其实还是很有简单的,你看这个还是有规律的,规律在于有分隔符|,我写了个DEMO
something = ’’’<li><span class='info-tit'>房屋概况:</span>住宅 <span class='splitline'>|</span>1室1厅1卫<span class='splitline'>|</span><span>46m²</span><span class='splitline'>|</span> (高层)/共18层<span class='splitline'>|</span>南北<span class='splitline'>|</span> 豪华装修 </li>’’’;soup = BeautifulSoup(something, ’lxml’)plaintext = soup.select(’li’)[0].get_text().strip()
通过get_text()得到内在所有内容,然后去除空格。后面你就用split进行分割吧,后面的不写了。如果有问题再交流。
回答2:我感觉这个html代码写错了呢,标签的内容文本在标签外面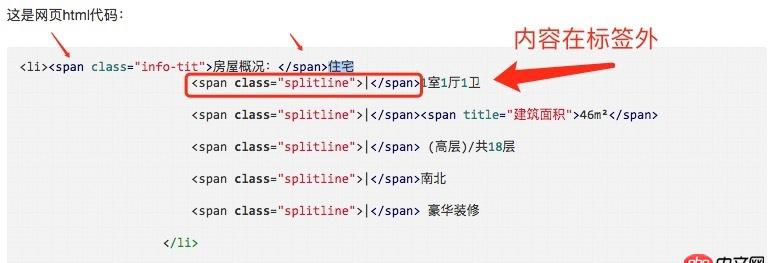
房屋概况:
46m²
回答3:innerText
回答4:你这种情况,我觉得用 for 循环加上正则表达式是最方便的,如果所有模版都是这样固定的话
回答5:用pyquery吧
from pyquery import PyQuery as Q
Q(text).find(’.house-info li’).text()
相关文章:
1. javascript - node如何关闭主进程后 打开另一进程?2. javascript - thymeleaf模板 只有length如何循环生成标签?3. 点字符“” 在MVC Web API 2中进行请求,例如api / people / STAFF.452874. 如何解决Centos下Docker服务启动无响应,且输入docker命令无响应?5. node.js - 我是一个做前端的,求教如何学习vue,node等js引擎?6. mysql - sysbench cpu测试的结果看不懂,求解7. java - 在Spring初始化过程中阻塞合理吗?8. docker - 各位电脑上有多少个容器啊?容器一多,自己都搞混了,咋办呢?9. 求大神指点js修改margintop导致无限下滑的问题10. 如何解决docker宿主机无法访问容器中的服务?
 网公网安备